

AI能否預判學術錄取?靈格封存萬篇論文預測
12月揭盲將檢驗文本評估的能力,也牽動研究篩選、資源分配與技術投資的判斷邊界
在學術會議公布評審意見之前,AI能否先辨識哪些研究將獲錄取?靈格宣布封存對10,368篇ICLR投稿的預測,計劃12月公開文件、逐篇核對。這項實驗的意義,延伸至誰能優先獲得專家注意、研究資金與企業接觸。不過,預測人類選擇與辨識科學突破仍有距離;當評估分數成為追逐目標,工具也可能改變它原本試圖測量的行為。
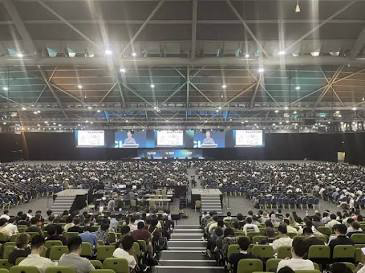 (圖片說明)國際學習表徵會議(ICLR)作為頂級機器學習學術會議,近年投稿量大幅激增,評審專家面臨巨大閱讀與審查壓力,成為AI輔助文本分析與預測研究的重要試驗場合。
萬篇預測等待揭盲
文本評估項目靈格(LingEQ)宣布,已於2026年11月3日封存對國際學習表徵會議(ICLR)2027年投稿的錄取預測,涵蓋10,368篇論文。其公開GitHub倉庫列出預測文件的數位指紋與時間戳證明檔,承諾在官方錄取結果公布後公開原始文件。按照ICLR日程,初評公開日為11月5日,最終決定預定12月16日公布;在逐篇結果可供比對之前,這項實驗尚無可確認的預測成績。
靈格選擇在結果揭曉前留下公開記錄,使外界日後有機會檢查預測文件是否與事前承諾一致。這種安排提供了一個可追溯的起點,模型是否掌握有效訊號,則須由結果、方法與資料記錄共同回答。
這個問題具有超出學術出版的吸引力。企業研發部門、研究資助機構與技術投資人,同樣需要在大量文件中決定先讀甚麼、找誰討論,以及把有限的專家時間放在哪裡。如果AI能在正式評審之前提供可靠線索,它可能改變研究被看見的順序;但一篇論文會否獲錄取、論證是否可靠,以及研究是否具有長期價值,仍須分別驗證。
評審人力承壓
ICLR是機器學習領域的重要國際會議。其官方資料列出,投稿量由2025年的11,603篇增至2026年的19,525篇,增加約68%。進入2027年,會議又引入投稿限額:所有作者適用20篇上限,從未在指定主要人工智能及相關領域會議發表論文的新作者,適用更嚴格的1篇上限。
程序主席在2026年9月的政策說明中,把這些措施描述為控制投稿流量的安排,並指出快速成長的研究領域可能沒有足夠合資格專家閱讀所有希望發表的成果。生成式AI降低了製作論文式文本的門檻,而確認推導、實驗與結論是否站得住腳,仍然需要專業時間。
這種壓力同時落在作者與評審身上。作者需要具體意見,才能知道研究應補充甚麼證據;評審則必須理解陌生方法、核對相關研究,並解釋接受或拒絕的理由。工具如果能幫助他們找到需要優先查核的問題,便有實際用途;如果只增加大量看似完整、卻缺少根據的評語,也可能加重雙方負擔。
靈格的實驗正落在這個需求之中:論文文本是否已包含足夠訊號,讓系統在初評公開之前估計人類評審體系的選擇?
 (圖片說明)同行評審系統中的評估數據與指標分析圖表,展示了學術出版體系如何透過量化指標與數據統計管理數萬篇投稿論文的初評與篩選流程。
「熵值」測量甚麼
根據項目方說明,靈格使用多個AI模型分析論文的概念關係、推理結構與證據支持程度,再參考往屆評審偏好估計錄取概率。項目把其中的文本評估稱為「語言熵值」,縮寫為LEQ。
這個名稱需要與既有技術概念區分。在資訊理論中,熵描述一個概率分布的不確定性;語言模型使用的交叉熵與困惑度,則可以反映模型對文本的預測程度。它們需要明確的概率模型與計算方式,不能直接換算為思想深度、論證嚴密度或科學原創性。
一段文字對模型而言難以預測,可能包含罕見術語或新表達,也可能只是語句混亂;容易預測的文字可能清楚流暢,也可能高度公式化。因此,「高熵」不必然代表突破,「低熵」也不必然代表缺少價值。
靈格公開倉庫表示,封存資料涵蓋31個研究分類,每篇論文包含錄取概率、LingEQ值及分類內排名,並將LingEQ值上限設為200,說明數值越高代表越可能獲錄取。這個定義把指數與錄取結果聯繫起來,卻沒有單憑名稱建立它與標準資訊熵之間的數學關係。
要理解系統偏好甚麼,需要知道評分如何形成,以及哪些因素推動分數上升。例如,在保留研究內容的情況下改寫語句,分數會變多少?補上關鍵實驗與增加專業術語,系統能否辨識兩者不同的價值?這類對照有助於分辨模型是在捕捉證據,還是在獎勵熟悉的寫作形式。
多個模型形成共識,也不自動等於獨立驗證。模型可能共享訓練資料中的偏好,或共同忽略同一類問題;評估方法的可信度,需要由外部測試逐步建立。
封存與資訊隔離
靈格公布的SHA-256指紋,是根據文件內容計算的校驗值,可用來核對日後公開的文件是否與事前承諾的版本一致。項目同時提供OpenTimestamps證明檔,表示已把這項承諾錨定於比特幣區塊鏈。
時間戳可以為資料在某個時間點之前已經存在提供證據,但完整核驗需要連接文件內容、雜湊值、證明檔的運算路徑與區塊鏈記錄。這項證明主要處理版本與時間先後,系統使用了哪些輸入、何時運行,以及是否接觸評審資訊,仍須由其他記錄說明。
ICLR評審指引將初評寫作安排在11月3日封存之前。因此,早於初評公開與早於評審寫作是不同條件,也不能據此推斷所有評審已按時完成。靈格表示其預測與本屆評審意見及作者答辯隔離,這項主張應由可追查的運行記錄支持。
較有說服力的記錄包括輸入論文版本及指紋、模型識別與設定、完整提示詞和工具呼叫、執行時間,以及每次輸出如何彙整為最終概率。這些資料有助於重建實驗,但自行產生的日誌仍可能不完整,若能配合事前存證或獨立稽核,證據會更充分。
公開亦有保密邊界。涉及受限制資料或第三方權利的內容,可以透過受控存取交由獨立研究者檢查;關鍵在於外界能否驗證重要主張,而非把所有資料不加區分地放上網。
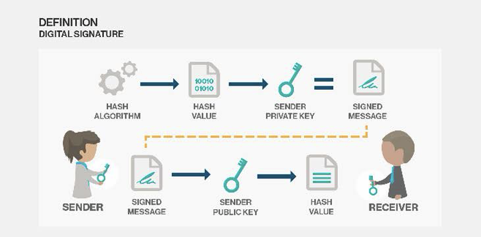 (圖片說明)數位簽章與密碼學雜湊(Hash)時間戳驗證機制示意圖,說明靈格(LingEQ)如何透過SHA-256與區塊鏈技術存證封存檔,以證明預測內容在特定時間點之前已存在。
樣本決定適用範圍
10,368篇是一個足以展開分析的規模,研究能否推廣至更大範圍,則取決於這批論文如何形成。
如果全文解析失敗的稿件被排除,模型可能較少接觸公式密集、版面特殊或附錄龐大的研究;如果某些領域入選比例較高,整體成績也會受到領域組成影響。樣本選取、排除條件及分類規則,因而應與結果一起公開。
錄取率的分母同樣會改變讀者的理解。ICLR官方2026年回顧列出19,525篇有效投稿、13,763篇取得接受或拒絕決定的論文,以及5,355篇錄取論文。依這組數字計算,錄取數佔有效投稿約27.4%,佔取得決定的論文則約38.9%。
兩個比例回答不同問題。前者描述全部有效投稿中的錄取比例,後者聚焦最後取得接受或拒絕決定的稿件。若一套預測把撤稿視為不錄取,另一套將撤稿排除,兩者的準確率便不能直接相比。
撤稿、程序退稿、缺失結果及論文版本變更的處理方式,應在揭盲前固定。否則,研究者可能在看見結果之後,選擇較有利的計算口徑。
26次選擇的含義
靈格材料引用哈佛大學Gary King與Steven Worthington的一項研究,以說明AI評閱的潛力。兩位研究者公開的工作論文使用124篇rapidPeer論文草稿及134份人類評閱意見,由Claude Opus 4.8生成AI意見,並使用GPT-5.5擔任AI評判。作者亦披露,他們設計並營運rapidPeer,存在利益衝突。
其中最容易被引用的結果,是三位前期刊編輯在30次匿名比較中,有26次偏好AI意見。然而,三位編輯比較的是同一組十對意見,研究沒有要求他們閱讀相應原稿,因此這並非30篇獨立論文的準確性測試。
研究為AI提供建設性修改意見的能力帶來支持,但沒有直接檢驗錄取決策,也沒有衡量作者採納意見後,論文實際改善多少。這項發現可以解釋外界為何關注AI評閱,卻不能替靈格的另一套方法預先提供效能保證。
 (圖片說明)研究人員正在核對統計模型在不同樣本領域的概率校準與邊界預測表現,反映了12月揭盲時對模型內部有效性與外部真實度進行檢驗的核心步驟。
會議保留判斷權
學術會議已開始把AI納入流程,同時對它可以做甚麼作出不同限制。
ICLR 2027允許有限、負責任的AI輔助評閱寫作,但要求披露。使用者須提供本人原先撰寫的評估,以及相關模型互動記錄;AI產生的錯誤陳述,或原始評估與最終意見之間的重大不一致,可能受到處分。
AISTATS 2027則為每篇投稿安排聚焦事實正確性的AI意見,不評新穎性與重要性、不打分,也不提出錄取建議。這份意見在初評寫作時不向人類評審顯示,按日程於11月16日與人類意見一併提供給作者,再於討論階段供評審與領域主席參考。最終決定仍由領域主席、資深領域主席及程序主席根據人類評閱與討論作出。
這些安排把工具用途與責任主體聯繫起來。靈格目前公布的是外部預測研究,其結果不應被誤認為ICLR官方評分或錄取意見。
分數成為目標之後
如果一個指標被證明能預測錄取,作者便可能開始針對它調整寫作。改善結構、補足證據與澄清方法,本來就是有益的修訂;問題在於,分數上升是否仍然對應研究品質改善。
這涉及通常以古德哈特定律(Goodhart’s Law)概括的風險:當代理指標成為追逐目標,人們的行為可能使它與原先要衡量的價值逐漸分離。ICML 2023一項研究在合成實驗中展示,對不完美的獎勵模型過度優化,可能使另一個參考模型衡量的表現下降。這提供了一個相關機制,但不等於已證明LEQ存在相同問題。
在論文評估中,可以設想兩種不同情況。一種是作者反覆改寫摘要、增加特定術語或套用模型偏好的結構,在研究內容變化不大的情況下提高分數;另一種是把操縱性指令藏入文件,試圖直接影響AI評閱。
後一種風險已有專門研究。研究者曾測試在論文PDF中嵌入人類不易察覺的提示,並在其實驗條件下觀察到AI評閱輸出受到影響。AISTATS 2027亦明文禁止用隱藏提示影響大模型評閱,並將此類行為列為學術不端。
因此,一套評估系統需要同時接受兩類檢查:它能否辨識實質改善,以及它能否抵抗只為提高分數而作的改動。若某個指標開始被廣泛使用,原有測試集上的成績也未必能長期維持,因為作者已經有機會學習它的偏好。
這是未來可能出現的制度回饋,不能寫成靈格已受到操縱。但對任何希望進入研究篩選流程的工具而言,這項檢驗都與準確率同樣重要。
準確率之外
12月揭盲時,一個整體準確率不足以說明系統的用途。
假設某個樣本只有四分之一論文獲錄取,把全部論文判為不錄取,也能得到75%的分類準確率。系統需要與簡單基準比較,才能看出它增加了多少資訊。
靈格提供的是概率預測,檢驗還應包括概率校準:被估計有七成機會的論文,實際是否約七成獲錄取;某些研究領域是否持續被高估;分類內排名靠前的論文,是否更常獲錄取。整體成績之外,邊緣案例與不同領域的表現,往往更能顯示工具的使用界線。
初評分數在取得後,可以成為較強的比較基準,但它與事前文本預測處於不同資訊時點。兩者比較有助於理解文本訊號與人類評閱訊號的關係,不能因後來取得更多資訊的模型表現較好,就否定事前預測的用途;同樣地,事前預測若沒有超越簡單基準,也不能只憑規模宣稱成功。
模型與人類評審分歧的論文尤其值得細讀。分歧可能來自模型錯誤、資料不足、評審偏好,也可能涉及一項尚未獲得充分理解的新方法;單憑最終錄取標籤,無法把這些原因完全分開。
 (圖片說明)產業投資人與機構分析師評估技術趨勢與研發資產的決策架構圖,說明AI論文預測工具若要真正應用於商業投資,仍須結合專利、數據與實際部署條件。
投資篩選如何使用
這類工具較具體的商業用途,可以先從安排閱讀順序開始,而不必直接介入投資決定。
例如,一家關注機器人技術的風險投資機構,可以設計一個試行流程:先在arXiv公開論文中,按技術領域、證據完整度與應用相關性建立候選清單,再由專家閱讀原文、檢查程式碼,並接觸研究團隊。錄取預測在其中只是一個輔助訊號,還須驗證它是否比關鍵詞搜尋或人工初選更有效。arXiv論文與會議投稿的分布亦有差異,ICLR樣本上的表現不能直接搬用。
企業研發部門也可以用類似方法尋找值得重現的研究。假設一家晶片公司正在評估降低模型推論成本的技術,系統可以協助整理候選論文及其效能主張,工程師再檢查硬體條件、測試設定與實際成本。能否獲錄取,無法替代這些驗證。
大學或研究機構則可以考慮把工具用於內部種子資助的初步整理,協助評審發現證據缺口與跨領域合作機會,但須另行檢查保密、偏見及申訴安排,避免一個不透明分數提前排除尚不成熟、卻值得探索的方向。
以上均屬可能的應用設計,現有材料不能證明靈格已完成相關部署。至於專利布局,公開論文可以提供技術線索,是否具有可申請的發明、權利歸屬與商業空間,仍須接受獨立的技術及法律評估,不能由錄取概率推導。
誰先獲得注意
同行評審會影響研究取得關注的機會,也與人才聘用、研究經費及計算資源配置相連。如果AI評估成為這些流程的入口,工具開發者所選擇的訓練資料、評分維度與排序方式,也會參與決定哪些研究先被看見。
這項影響未必直接表現為接受或拒絕。一篇論文只要長期排在候選清單後面,便可能少一次專家閱讀、少一次企業接觸,或錯過一項合作機會。因此,使用機構需要知道分數的理由、適用範圍,以及人可以在甚麼地方提出異議。
靈格的實驗提供了一個可以追蹤的測試起點:在官方結果公布之前留下預測承諾,再讓外界逐篇對照。它能否進一步成為有用的研究工具,取決於方法是否可重現、錯誤是否完整呈現,以及系統能否在被人刻意優化之後仍然保持辨識力。
對等待評審結果的作者、承擔閱讀責任的專家,以及依靠研究作決策的人而言,AI最有價值的貢獻,是讓有限的注意力更接近值得查核的證據。12月的結果可以回答這套方法預測得多準;至於它能否幫助人們作出更好的研究與資源決定,還需要下一步的實際檢驗。
免責聲明
本文依截至2026年11月6日的公開資料及項目方文件撰寫,僅供新聞研究與資訊參考,不構成工具效能認證、投資或法律建議;會議日程與研究結果可能更新。