

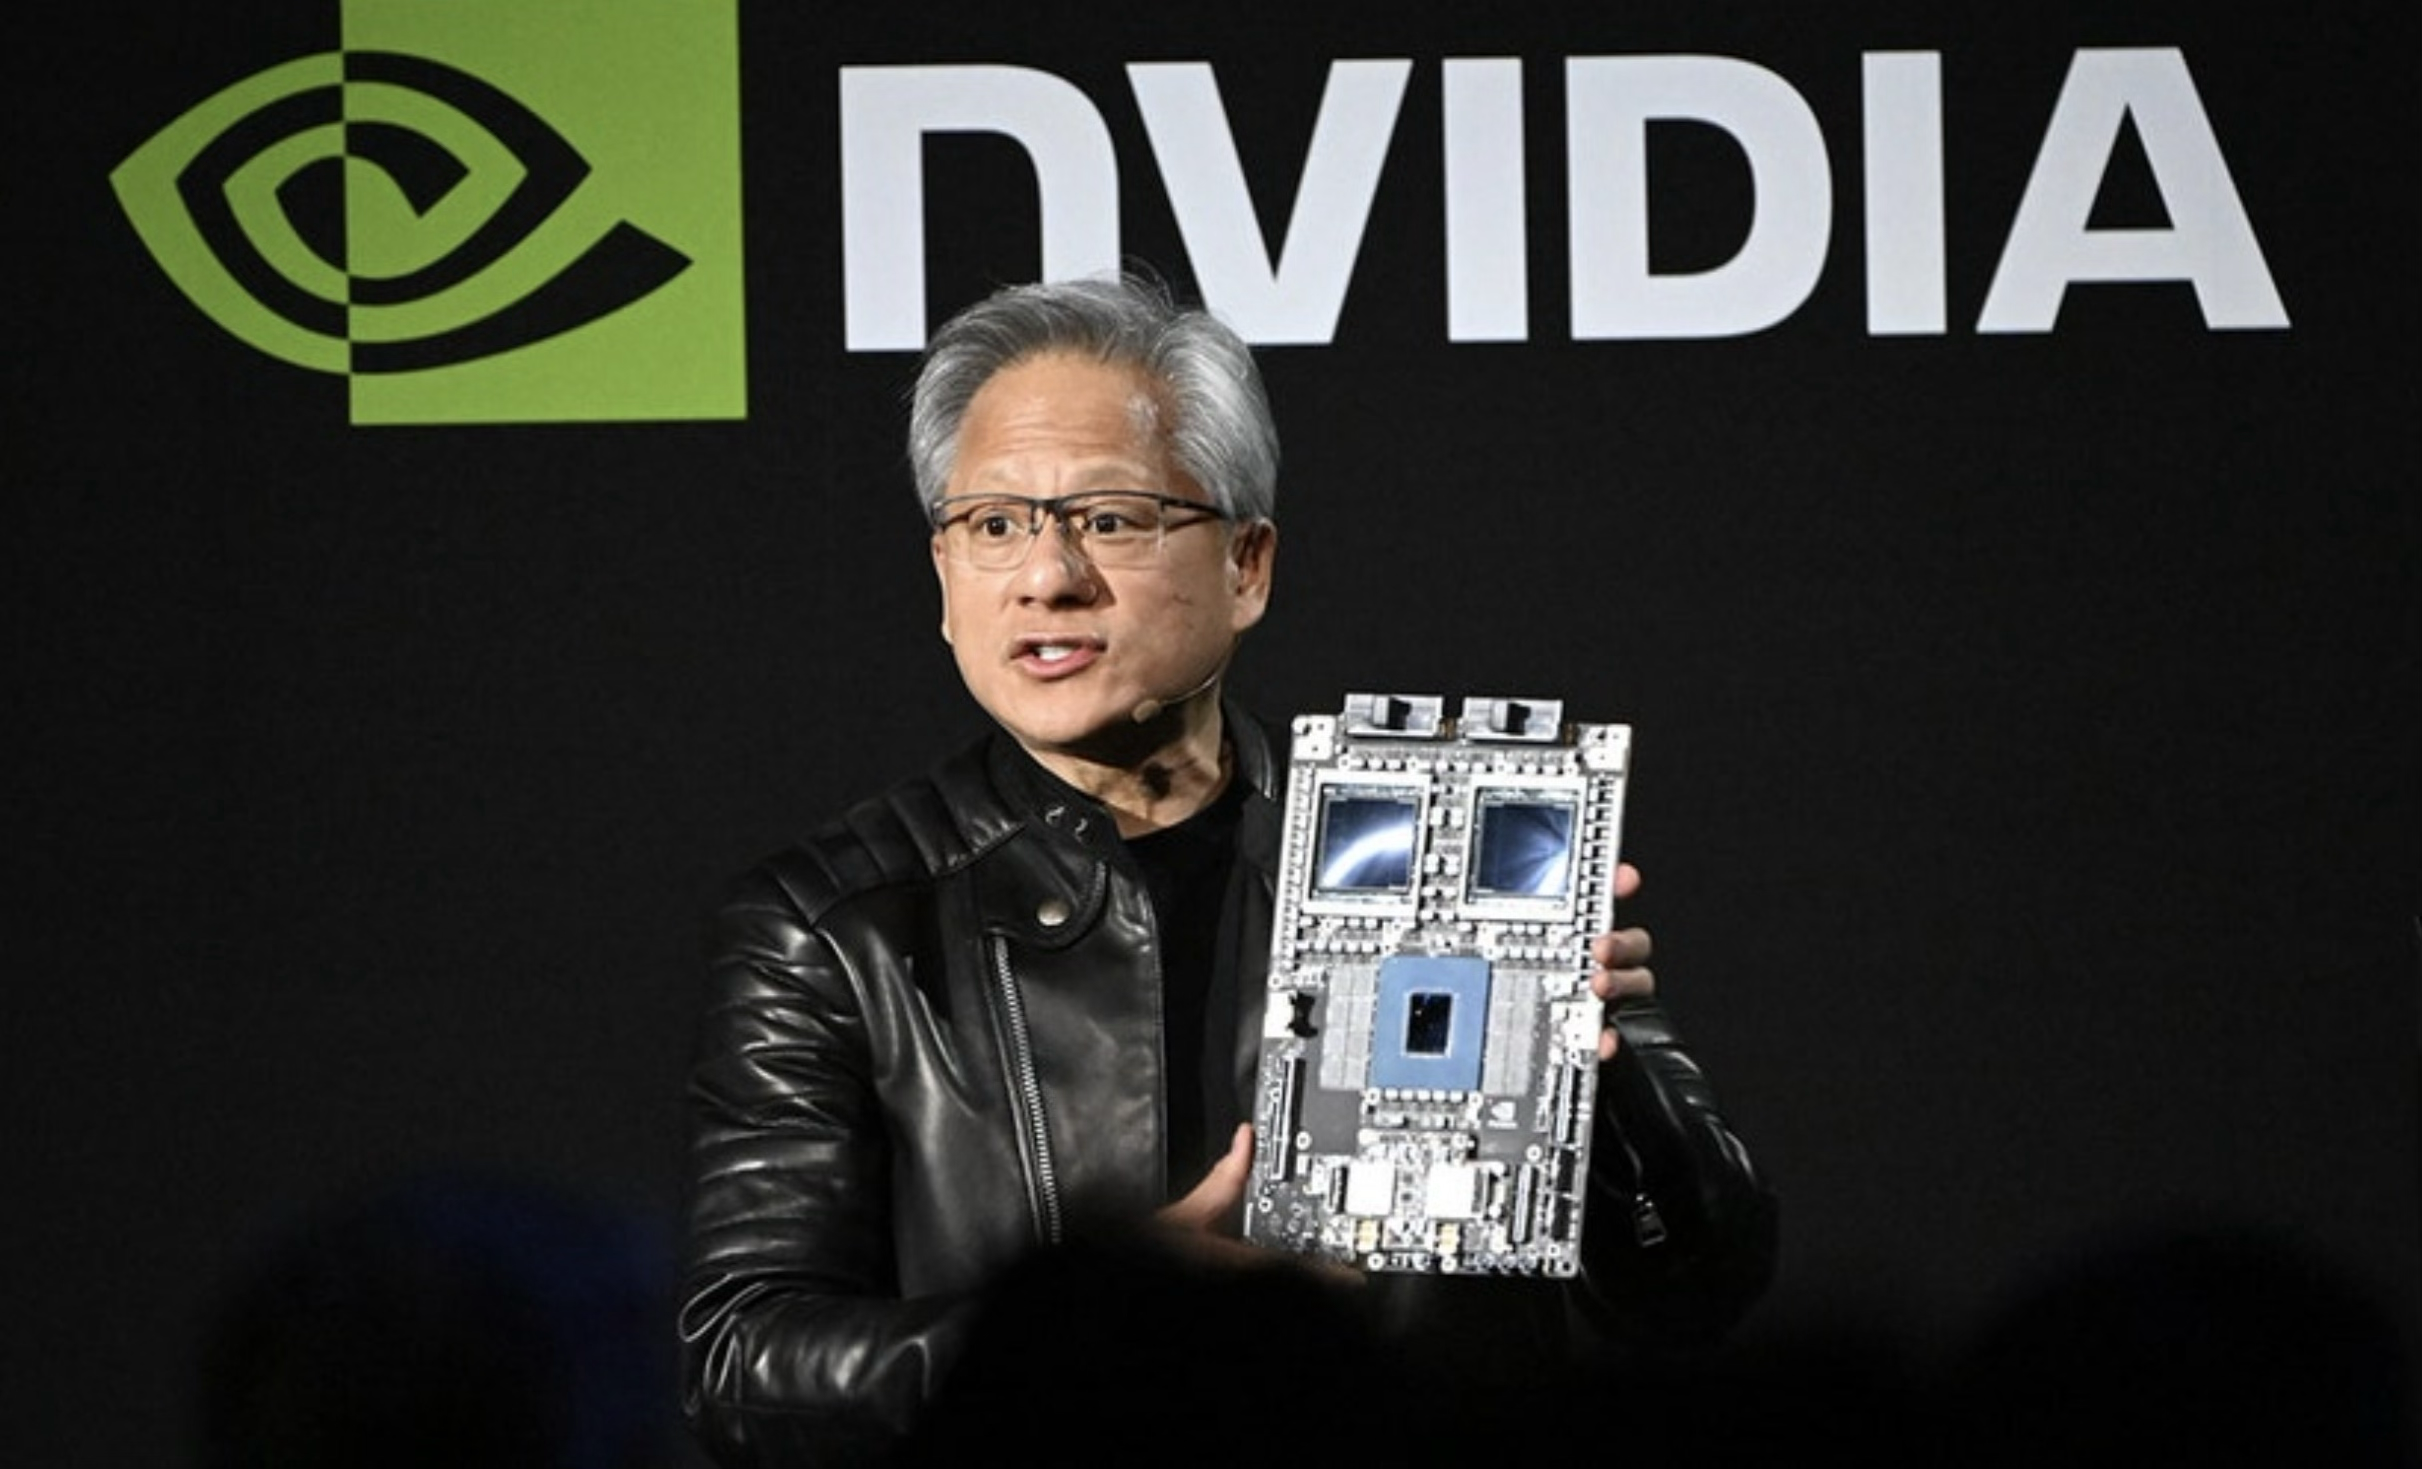
 (图片说明)黄仁勋(Jensen Huang),NVIDIA 执行长与联合创办人,推动AI 基础设施与算力扩张的关键人物,正与全球能源与电网挑战交锋。
当世界谈论AI ,为何总会绕回NVIDIA
在人工智慧的时代叙事中,黄仁勋(Jensen Huang)几乎是一个无法回避的名字。当世界热议大模型、生成式AI、智能体与通用人工智慧的未来时,人们表面上在谈参数、架构与推理速度,实际上在谈一个更底层、更难被浪漫化的问题:算力是否能被持续、稳定、规模化地供应。而这个问题的供给端,在2024–2026 的产业节拍里,往往都指向同一个方向——NVIDIA。当Blackwell 世代被推上前台,GPU 的能效叙事固然耀眼,但更刺耳的讯号是功耗与功率密度:单颗B200 被业界普遍理解可达约1kW 甚至更高等级,意味着「算力升级」不再只是更强晶片,而是把电力、冷却与电网接入一并推向极限的系统工程。当你把它放进宏观尺度,黄仁勋的角色便不再只是晶片公司的CEO,而是把算力曲线推到全社会必须为之供电的人:工程师会追着他的路线图跑,投资人会追着他的出货节奏跑,而能源公司、公用事业与电网营运者,则被迫追着他所带来的负载曲线跑。这也解释了为什么他近年最具穿透力的话,往往不是「更快」,而是「更吃电」:不是为了渲染焦虑,而是在提醒整个产业——AI 的现实边界正从算法与晶片,移向能源与电网这条更慢、更硬、也更难被短期资本解决的轨道。
⸻
从「部件」到「工厂」:黄仁勋如何重命名资料中心
早期的GPU,在黄仁勋的视野中更像一种高性能计算工具,服务于图形渲染、科学模拟与特定加速场景;那时的NVIDIA 更像「加速计算」的供应商,GPU 是伺服器里的一个部件——重要但仍从属于更大的IT 架构。然而2023 年后,生成式AI 引爆的不是单一产品线,而是一种新的生产形态:模型规模从百亿到万亿,训练周期从数周拉长到数月,推理从偶尔被呼叫变成24/7 的持续吞吐,算力需求不再是「阶段性投资」,而是「持续性消耗」。就在这个节点,黄仁勋反覆提出「AI 工厂(AI Factory)」的说法——这不是修辞,而是一种结构性重命名:资料中心不再是伺服器房,而是工厂;工厂的逻辑是连续运转、稳定供应、原料投入与产能输出;在AI 工厂里,输出的产品可以是token、推理结果、模型能力与企业收入,但投入的原料却越来越清晰地指向能源。当一个产业开始用「工厂」来描述资料中心,电力就不再只是OPEX 里的一行费用,而是「能否开工」的前提条件;同时,冷却与水资源也不再是运维细节,而是工厂能否长期运转的生命线。你会发现,黄仁勋真正改写的不是一段演讲,而是整个产业如何理解资料中心:从IT 设施,变成能源密集型的工业设施;从企业内部问题,变成公共基础设施问题。这一步,才是他把「能源」从幕后推到台前的关键动作。
⸻
一个无法回避的锚点: IEA把「电」写进AI的世界叙事
很多人习惯用「效率提升」来解释AI 的能源焦虑:每代晶片更省电、每token 成本更低、液冷与互连更进步,所以总能耗不会失控。但这是典型的「单点效率」迷思:当算力部署数量与使用频率以近乎指数级放大时,总量效应会迅速吞噬效率红利。国际能源署(IEA)在《Energy and AI》报告中给了全世界一个很硬的锚点:2024 年全球资料中心用电约415 TWh ,到2030 年在其基准情境中将逼近945 TWh ,并明确指出AI 是推动资料中心电力需求增长的最重要因素之一;这个量级相当于把资料中心用电推向「国家级」尺度,而不再是少数企业可以用采购策略自行消化的范围。更关键的是,IEA 的叙事并非只在讲「更多用电」,而是在讲「用电增长的节奏」:资料中心用电增长速度显著高于整体用电增长,意味着它会在局部地区更快形成供需紧张,并把输电、变电、互联排队、设备供应链等问题推到前台。当IEA 用这样的公共语言把「电」写进AI 的世界叙事,它实际上替黄仁勋那句「能源才是瓶颈」提供了宏观背书:你可以不喜欢这个结论,但很难否认这个趋势。从这一刻起,AI 的故事不再只是模型与晶片的故事,而是能源系统与制度时间的故事;而人物报导要做的,就是把这个巨大的系统压力,透过一个代表性人物的选择与语言,具象化成读者能理解的真实成本。 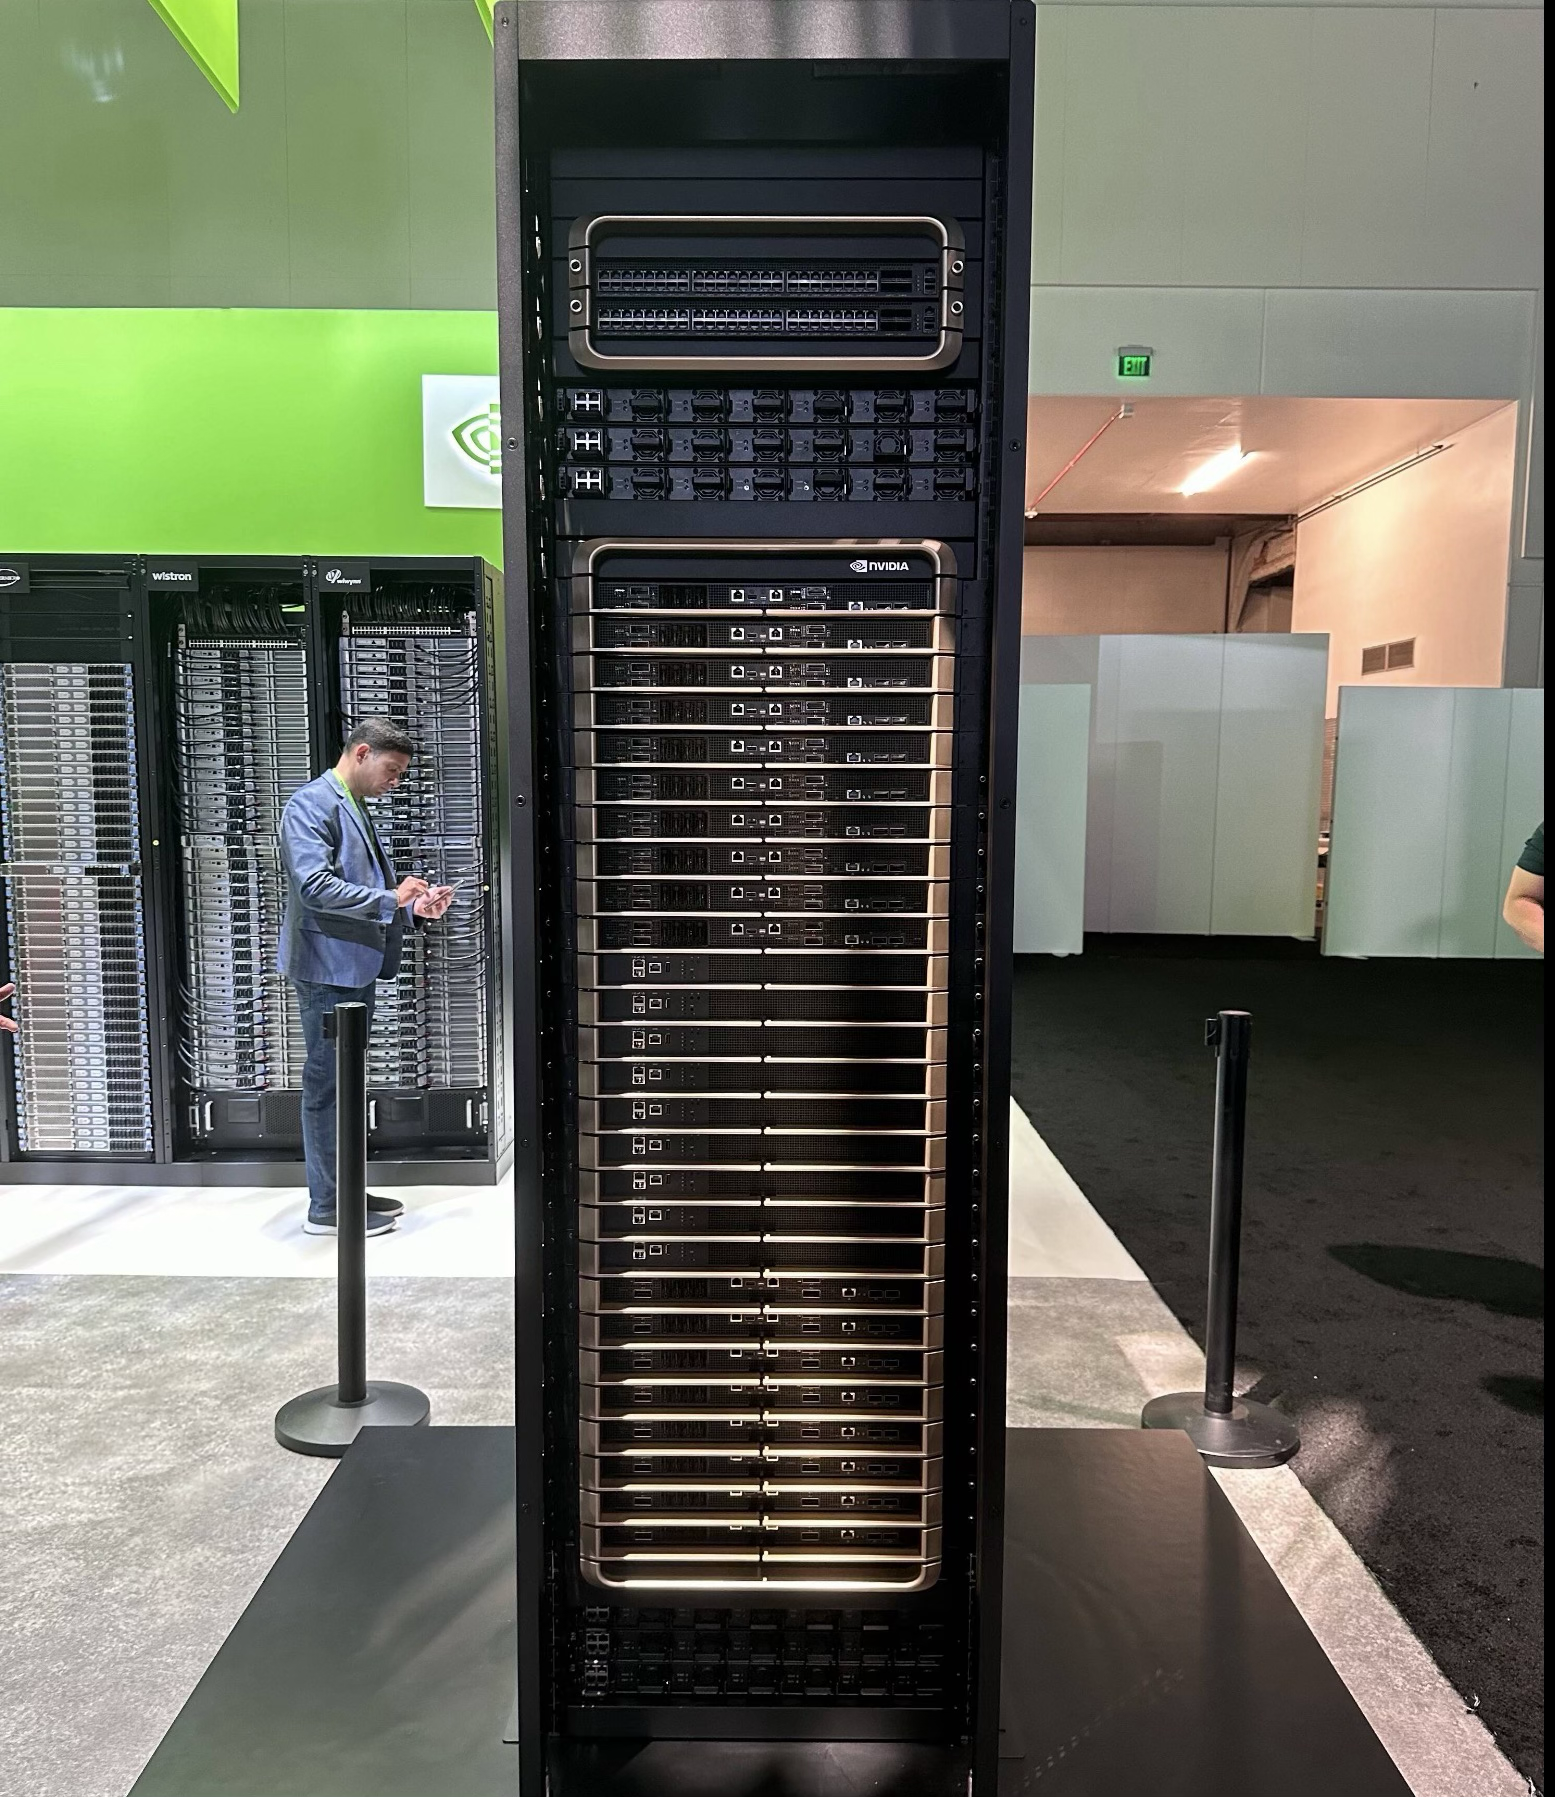 (图片说明)机柜级AI 系统把算力从「伺服器部件」推向「工业产能」:密度越高,对供电、散热、机房设计与并网时间的要求越接近电力基础设施等级。
⸻
北维吉尼亚的惊魂:当60座资料中心「同时跳脱」
如果说IEA 的数字描绘了「长期趋势」,那么北维吉尼亚「Data Center Alley」的事件则揭示了「系统风险」的真实面孔。 2024 年夏季的一次电压扰动中,约60 座资料中心在保护机制下转向备援电源,造成大规模负载瞬间从电网消失,逼使电网营运者紧急调降发电,避免连锁失衡;路透社对此报导时指出,这类事件让电网营运者更担忧资料中心在电压波动下的「不ride-through」行为,因为它把一个局部扰动放大成系统级挑战。 NERC 也针对大型负载损失事件发布事件回顾,说明资料中心负载对电压扰动敏感,且其保护与控制逻辑往往优先避免设备受损,导致负载快速转移至备援系统。这里的重点不只是「缺电」,而是「电网稳定性」:资料中心像高度精密又高度集中的工业负载,它不只是用电多,还可能在特定扰动下呈现集体行为,让电网在短时间内承受巨大调节压力。这种风险,恰恰是AI 工厂化后才变得尖锐:你可以把资料中心分散得更广,也可以要求更严格的ride-through 标准,但任何一种选择都牵动设备成本、可靠性、地方政策与公私协调。于是你会理解,黄仁勋口中的「吉瓦级AI 工厂」不是炫耀规模,而是在提醒:当AI 进入工业尺度,它会自然把自己写进公共电网的操作手册里,变成必须被规范、被治理、被纳入安全评估的对象。 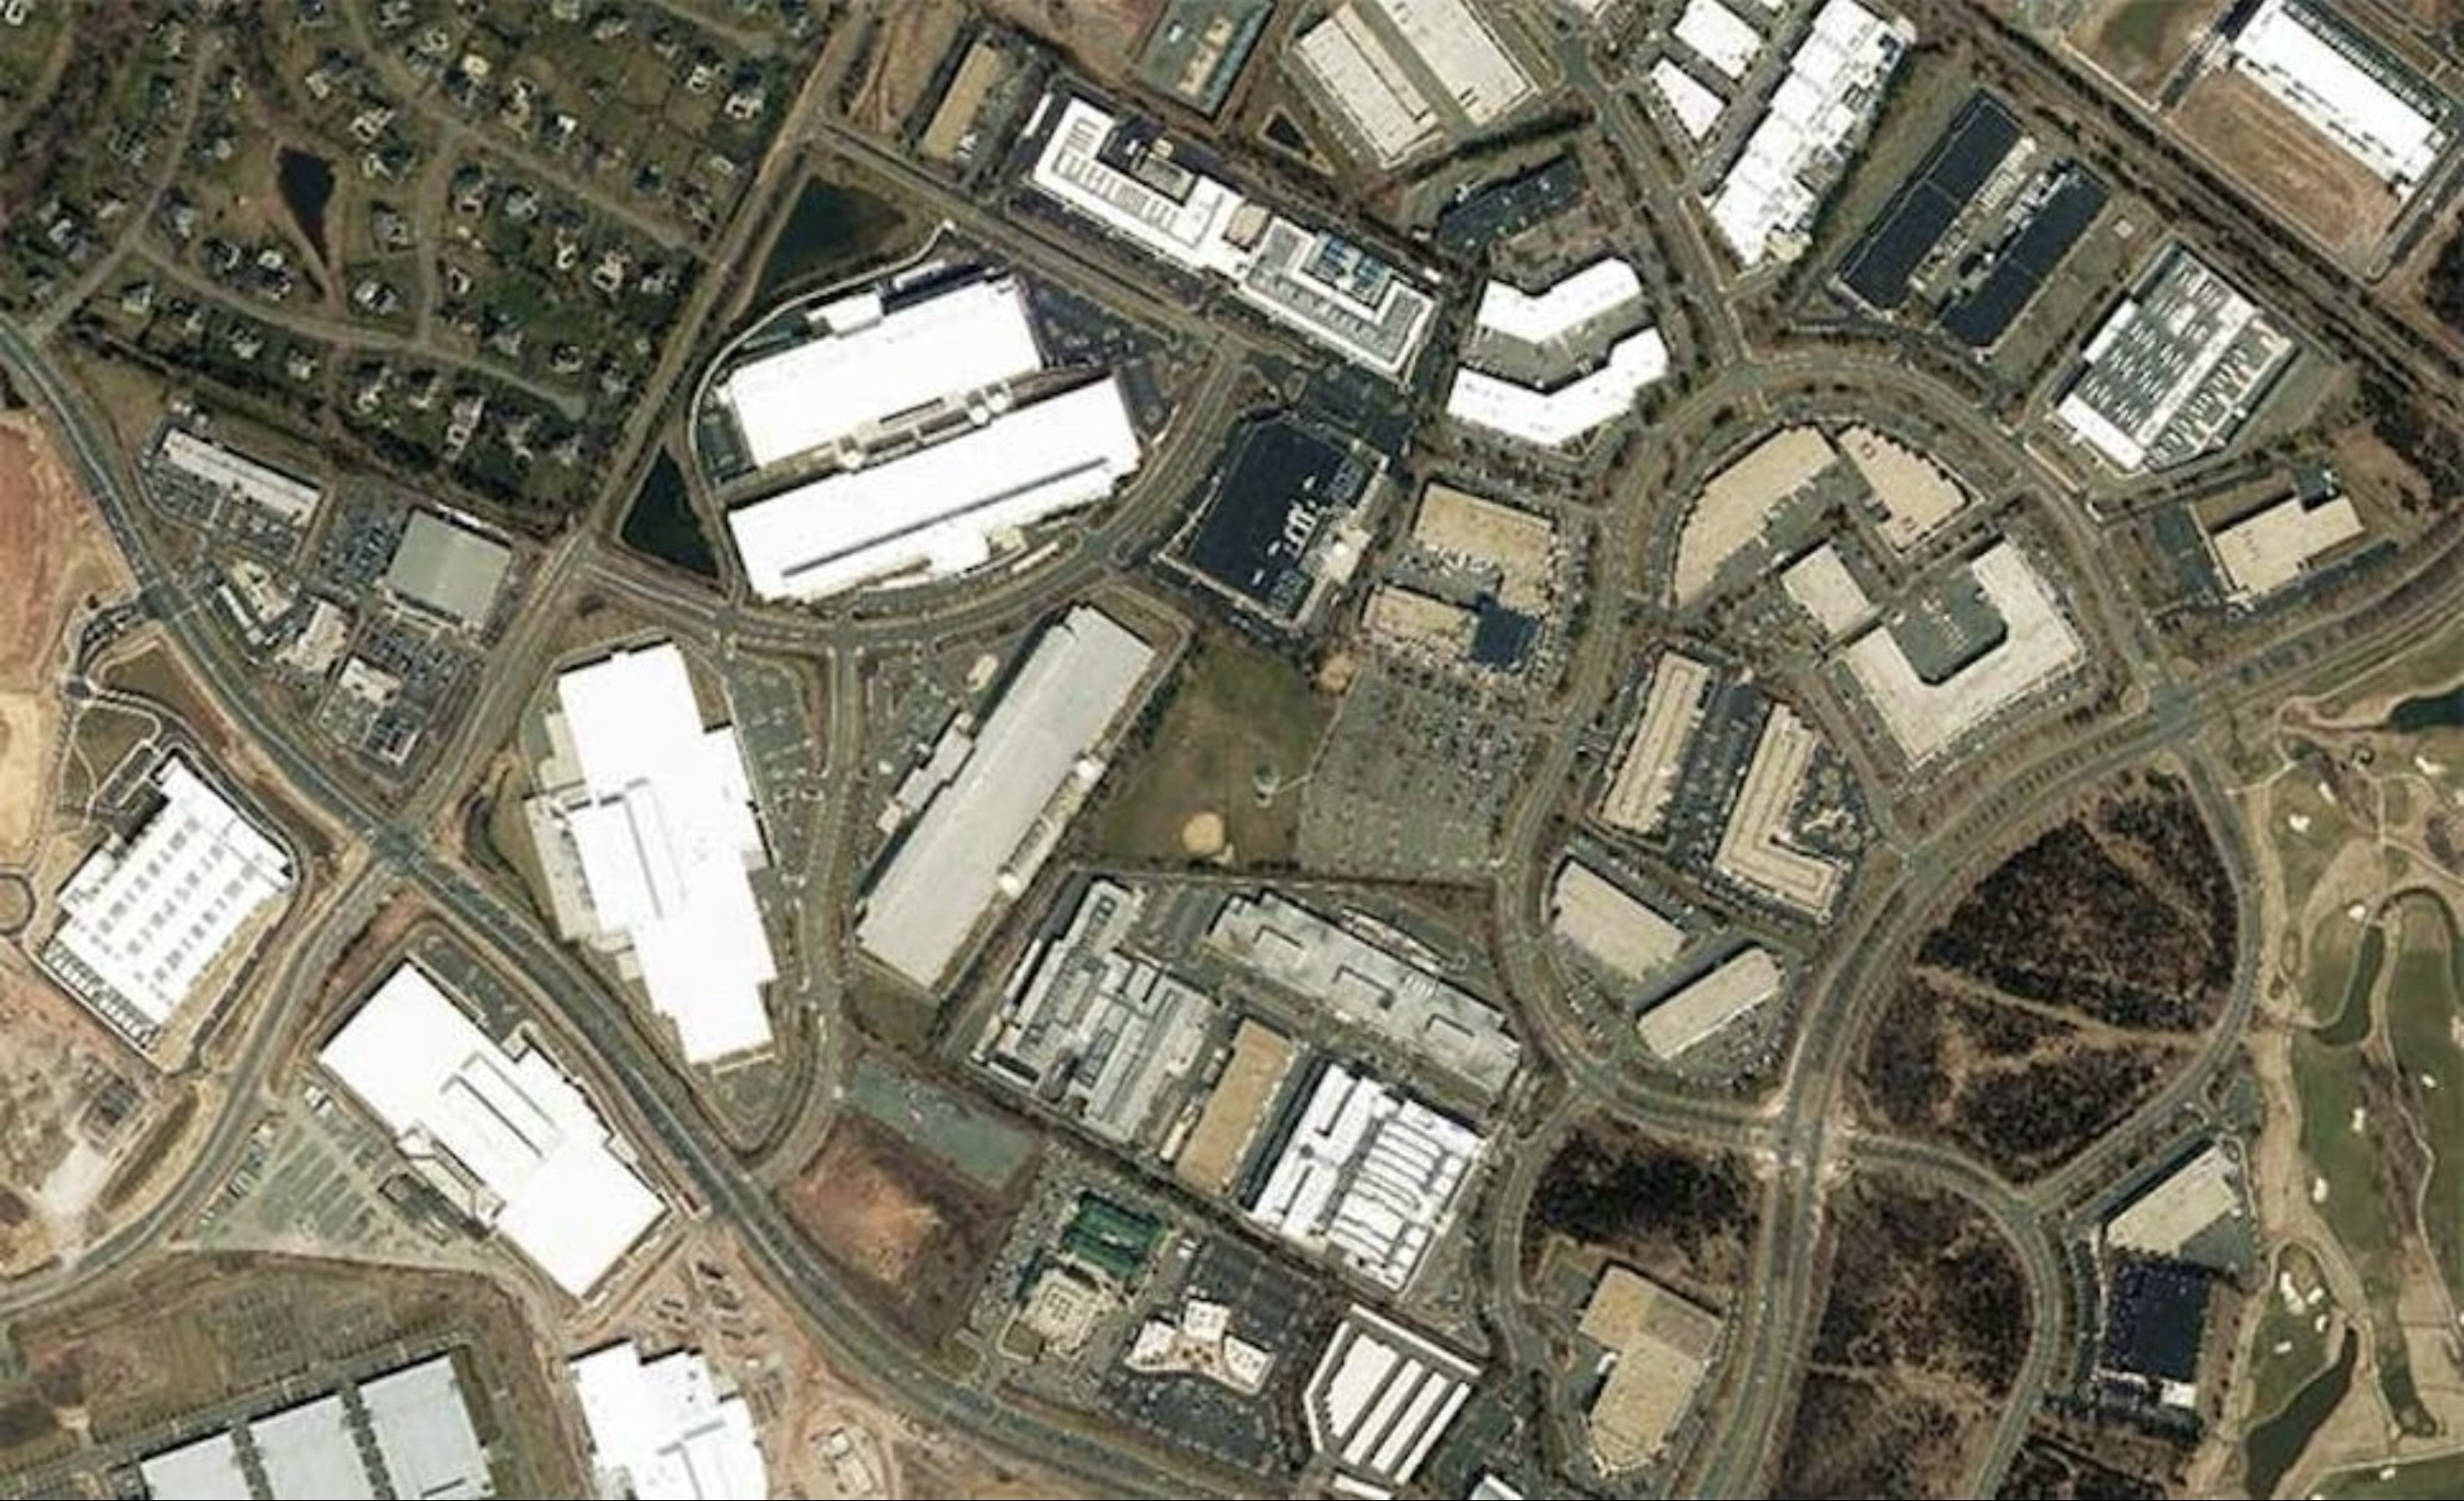 (图片说明)北维吉尼亚(Data Center Alley)是全球最密集的资料中心集群之一:当算力在此类枢纽加速堆叠,供电接入、输电能力与系统韧性便成为扩张速度的硬约束。
⸻
「 25倍能效」与「总量爆炸」:宣传与现实之间的落差
NVIDIA 的平台宣称能在推理上达到数量级的性能与能效提升,这类叙事在产业上并不罕见:新的精度格式、新的互连、新的系统级设计,再加上液冷,确实能把单位算力的能效推到更高。问题在于,当算力从「实验室级」走向「产业级」,从千卡集群走向吉瓦级AI 工厂,单点能效的提升会被部署规模的爆炸吞没。 B200 的功耗级别、机柜级NVL 系统的功率密度、以及液冷设备成本的攀升,都在提示同一件事:AI 的下一阶段竞争,不仅是性能竞赛,更是「把热与电处理好」的工程竞赛。近期甚至出现针对单一机柜液冷系统成本的市场报告与媒体报导,显示冷却系统本身已成为一笔可被单独计价、单独比较、单独成为瓶颈的成本项;而在大型云端部署情境里,冷却方案还会牵动水资源策略与可持续承诺,出现「节能」与「节水」之间的取舍。当外界只看到「推理快了多少倍」,GFM 更关心的是:在大规模部署后,这个快,是用多少电、多少热密度、多少冷却资本、多少供电排队时间换来的。黄仁勋的特别之处在于,他并未把这些成本永久藏在幕后;相反,他一次次用「工厂」「吉瓦」这样的词,把宣传语言推回工程语言——因为他知道,如果成本与边界不被提前说清楚,最终产业会在最昂贵的地方撞墙:不是撞在晶片上,而是撞在电网、变压器、冷却与制度时间上。
⸻
真实成本为何在2025–2026浮现:从CAPEX转向「电与时间」
AI 的早期成本,确实以资本密集型投入为主:晶片采购、伺服器集群、研发成本、供应链竞争。这些成本有一个共同特征——它们能在12–18 个月的技术迭代周期中被快速改写:制程进步、架构升级、软体栈优化,都会让同样预算买到更高算力,于是产业形成一种习惯性的信念:瓶颈出现了,就等下一代。但当部署进入2025–2026 的规模化阶段,成本结构悄然换挡:电力、散热、基础设施建设、电网接入与互联排队,从后台运营费跃升为前台刚性成本;更致命的是,这些成本不跟着晶片迭代而快速下降,它们受制于物理与制度:电厂要立项与环评,输电要规划与征地,变电要设备与工期,并网要标准与协调。于是「买更多GPU」不再是完整答案,因为你可能会遇到「买得到GPU,却买不到电」「有电价,但没有接入能力」「有土地,但要等数年才能并网」。这就是「真实成本」浮现的本质:它不只是更大的帐单,更是更长的等待与更高的不确定性。当电网营运者、监管者开始讨论资料中心能否被可靠服务、是否需要新的可靠性规则,这意味着AI 的扩张已不再只由市场决定,而会被公共规范重新塑形。黄仁勋的角色因此变得更复杂:他既是算力革命的引擎,也是能源约束的放大镜——他把产业带到一个不得不面对现实的阶段:天花板不再是算法或硅片,而是你能否为工厂找到燃料,并在制度时间里把燃料送到门口。 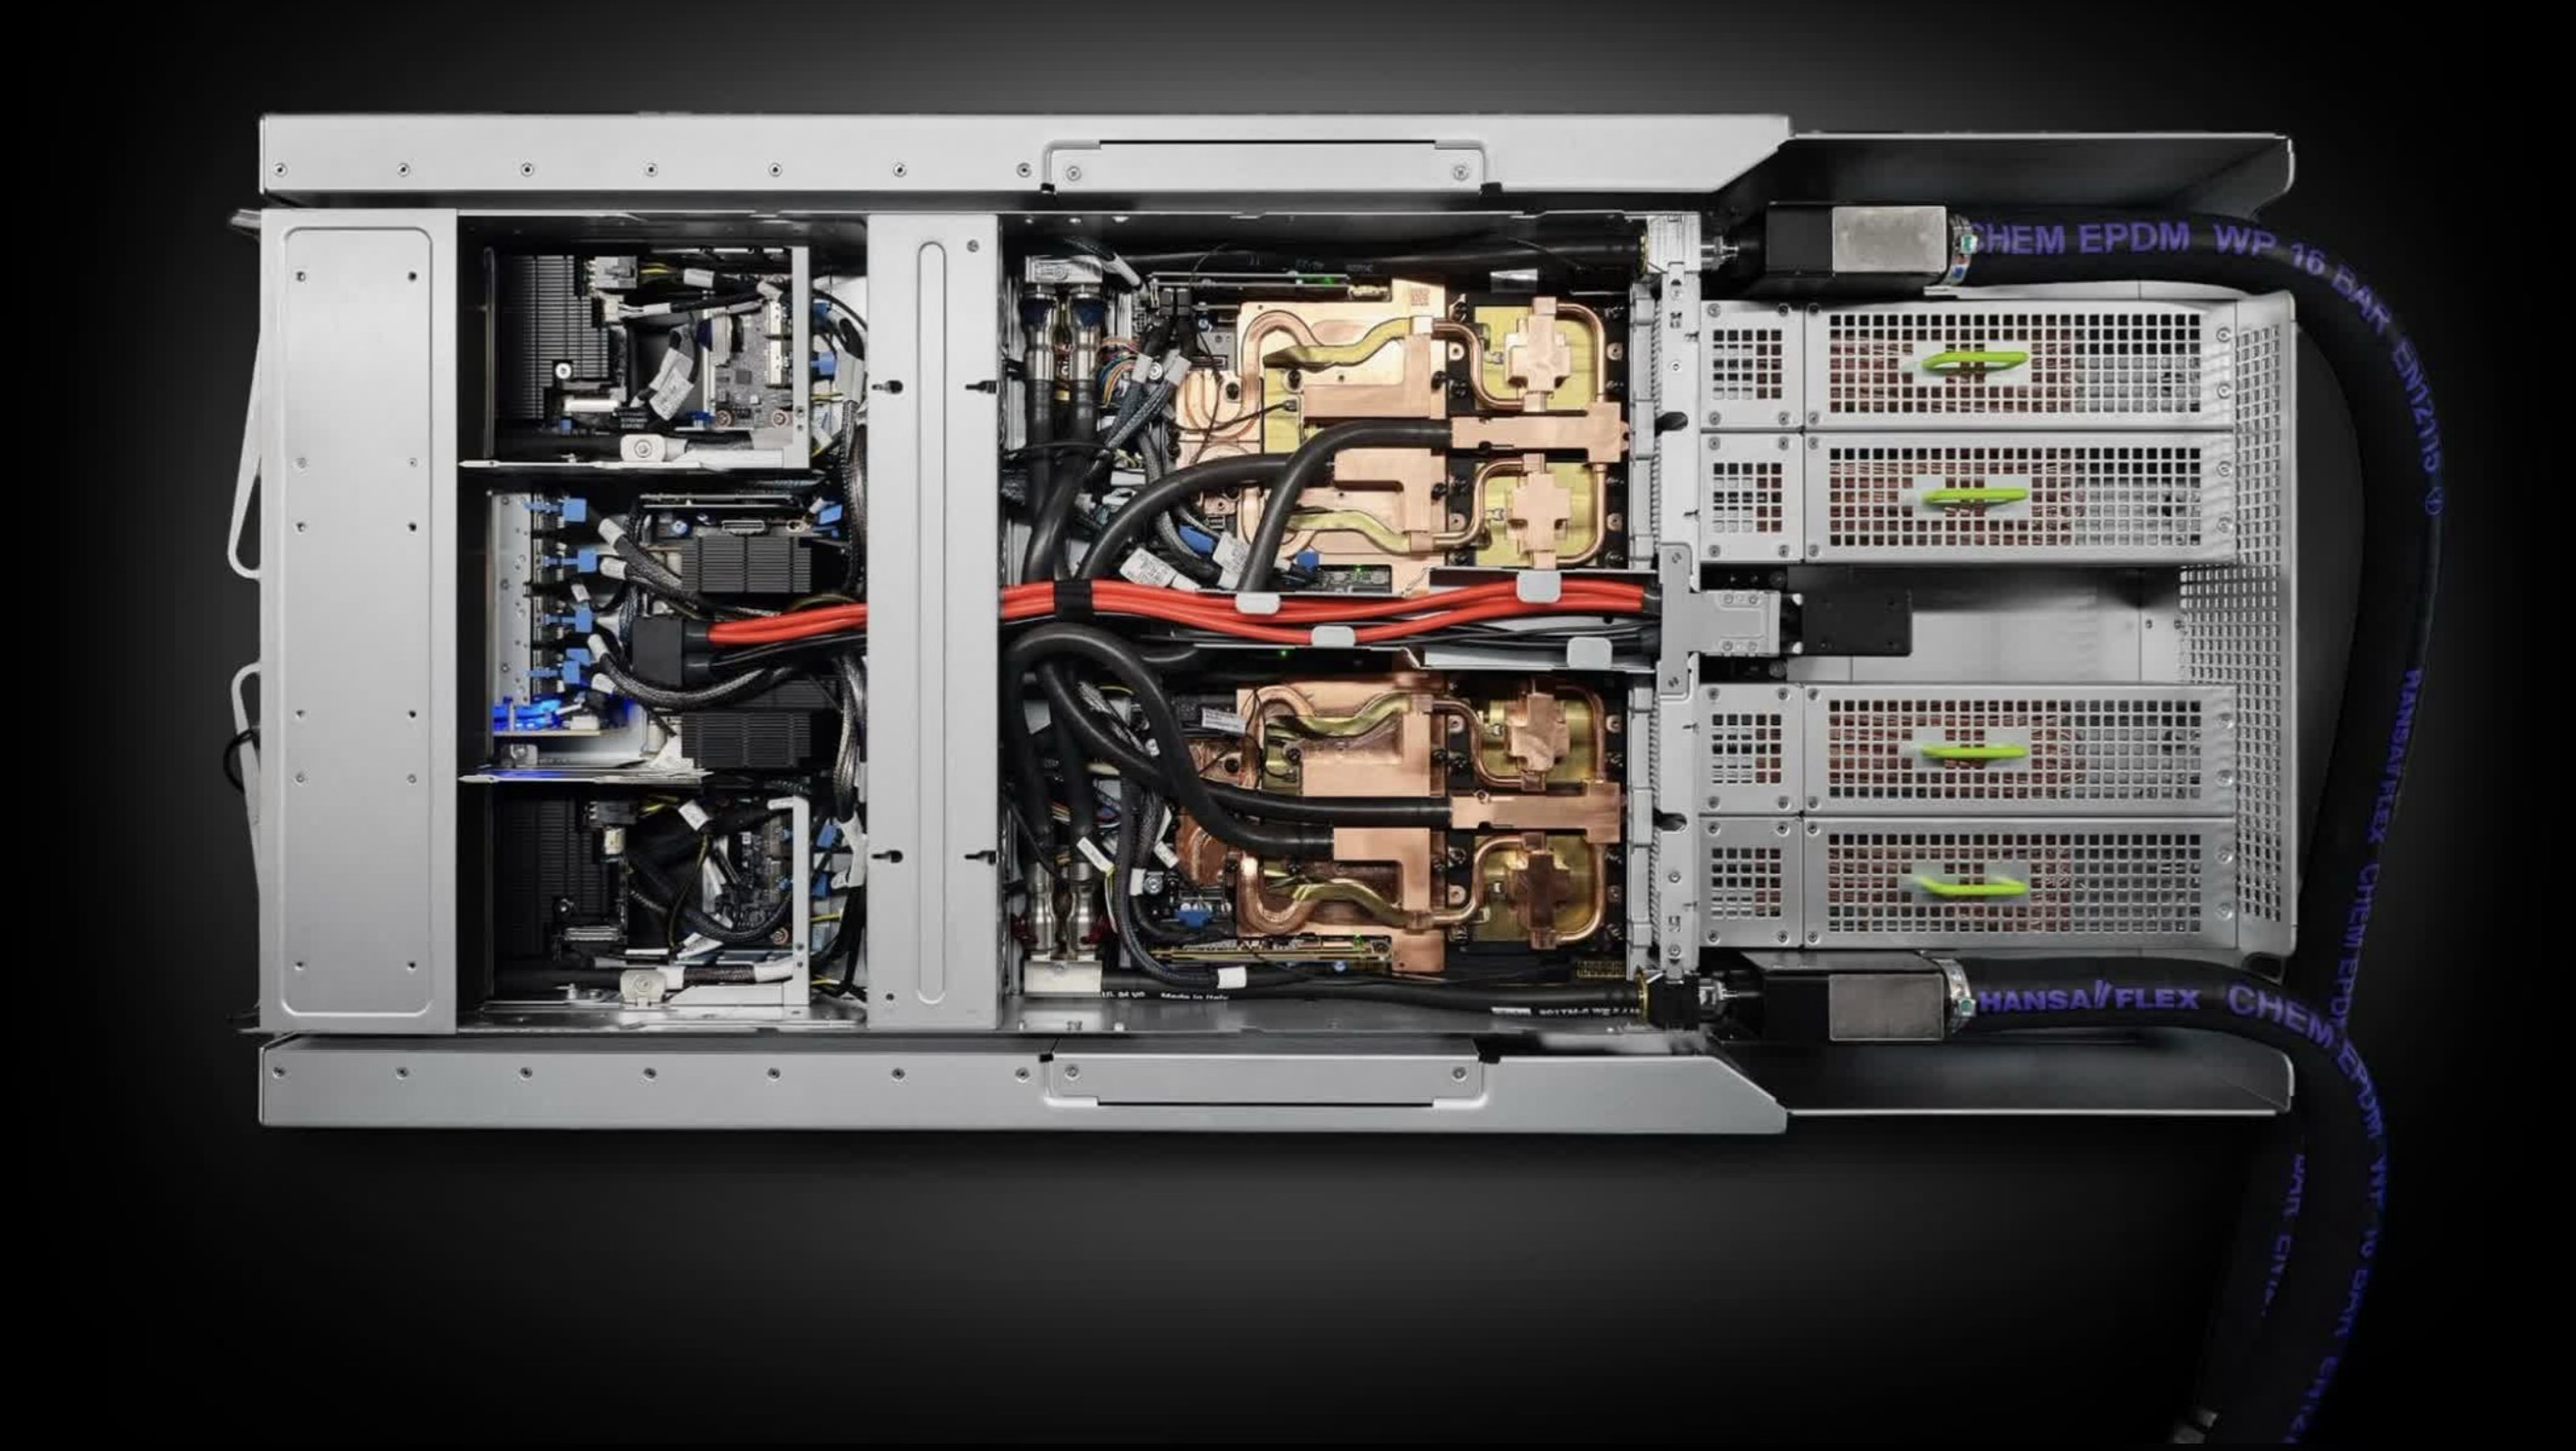 (图片说明)机柜级AI 系统把算力从「伺服器部件」推向「工业产能」:密度越高,对供电、散热、机房设计与并网时间的要求越接近电力基础设施等级。
⸻
制度时间差:晶片一年一代,电网十年一轮
晶片行业沉浸在高速迭代的节奏中:12–18 个月一代新架构,性能成倍、能效跃升,这种速度塑造了整个AI 产业的心理预期——「等下一代就行」。但能源系统遵循完全不同的规律:发电与输电是十年尺度的工程,环评、征地、融资、设备供应链、地方政治协调,每一项都可能把工期拉长。这就是你在「制度时间」框架里抓到的核心矛盾:算力曲线是近似摩尔定律的指数曲线,电网曲线却没有摩尔定律;它被材料、施工、标准与治理机制锁住。北维吉尼亚事件之所以具有象征性,正是因为它把「时间差」具象化:资料中心能在短期内快速扩张,但电网要在扰动中维持稳定,却需要长期制度与工程投入。当NERC 以事件回顾的方式呈现资料中心负载对电压扰动的敏感性,它其实是在告诉市场:再多的算力扩张,如果不把电网韧性与操作规范同步升级,风险会以非线性的方式累积。黄仁勋在多个场合反覆提到「电网不可能像晶片那样快」,其实不是在抱怨,而是把产业从“纯技术叙事”拉回“系统工程叙事”:AI 进入工业尺度后,真正的竞争力不只是谁的GPU 更快,而是谁能把算力部署在更可靠、更可持续、更可治理的能源底盘上。这句话对GFM 的意义在于:我们写人物,不是写传奇,而是写他所揭示的制度与现实——因为那才是决定下一个十年的力量。
⸻
从企业问题到公共议题: AI为何必然走向国安与民生
在AI 算力尚小的早期,能源问题多停留在企业内部可控范围:签电力采购协议、协商优先供电、自建备用发电、做behind-the-meter 方案,似乎就能解决。然而当算力从兆瓦级跃升到吉瓦级,当资料中心集群的峰值负荷等同一座中型城市,能源问题就必然跨越企业边界,成为公共议题:居民电价的波动、工业用电的挤压、地方电网的可靠性、极端气候下的供电安全,都会被放大。路透社在报导北维吉尼亚事件时已指出:资料中心对电压扰动的敏感性与大规模切换行为,正在迫使监管者与电网营运者重新思考可靠性标准;而这种标准一旦改写,就会影响资料中心的设计、成本与部署节奏,进而影响AI 的供给曲线。更深层的是国家安全:当AI 进入军事分析、指挥决策、关键基础设施管理,电网就成为「风险放大器」——不是因为它脆弱,而是因为它承载了太多依赖即时算力的系统。一旦供电中断或电网遭受攻击,算力优势可能在数小时内蒸发。黄仁勋在这个背景下的位置非常象征:他一方面推动更密集、更强大的算力平台,另一方面又一次次提醒「AI 从能源开始」——他等于把一个原本可被企业内部消化的问题,变成政策圈、国会听证与国安评估必须正视的结构性挑战。人物写作在此刻才真正有了重量:因为它不只是记录一个人,而是记录一个人如何把整个世界推向必须面对的现实。 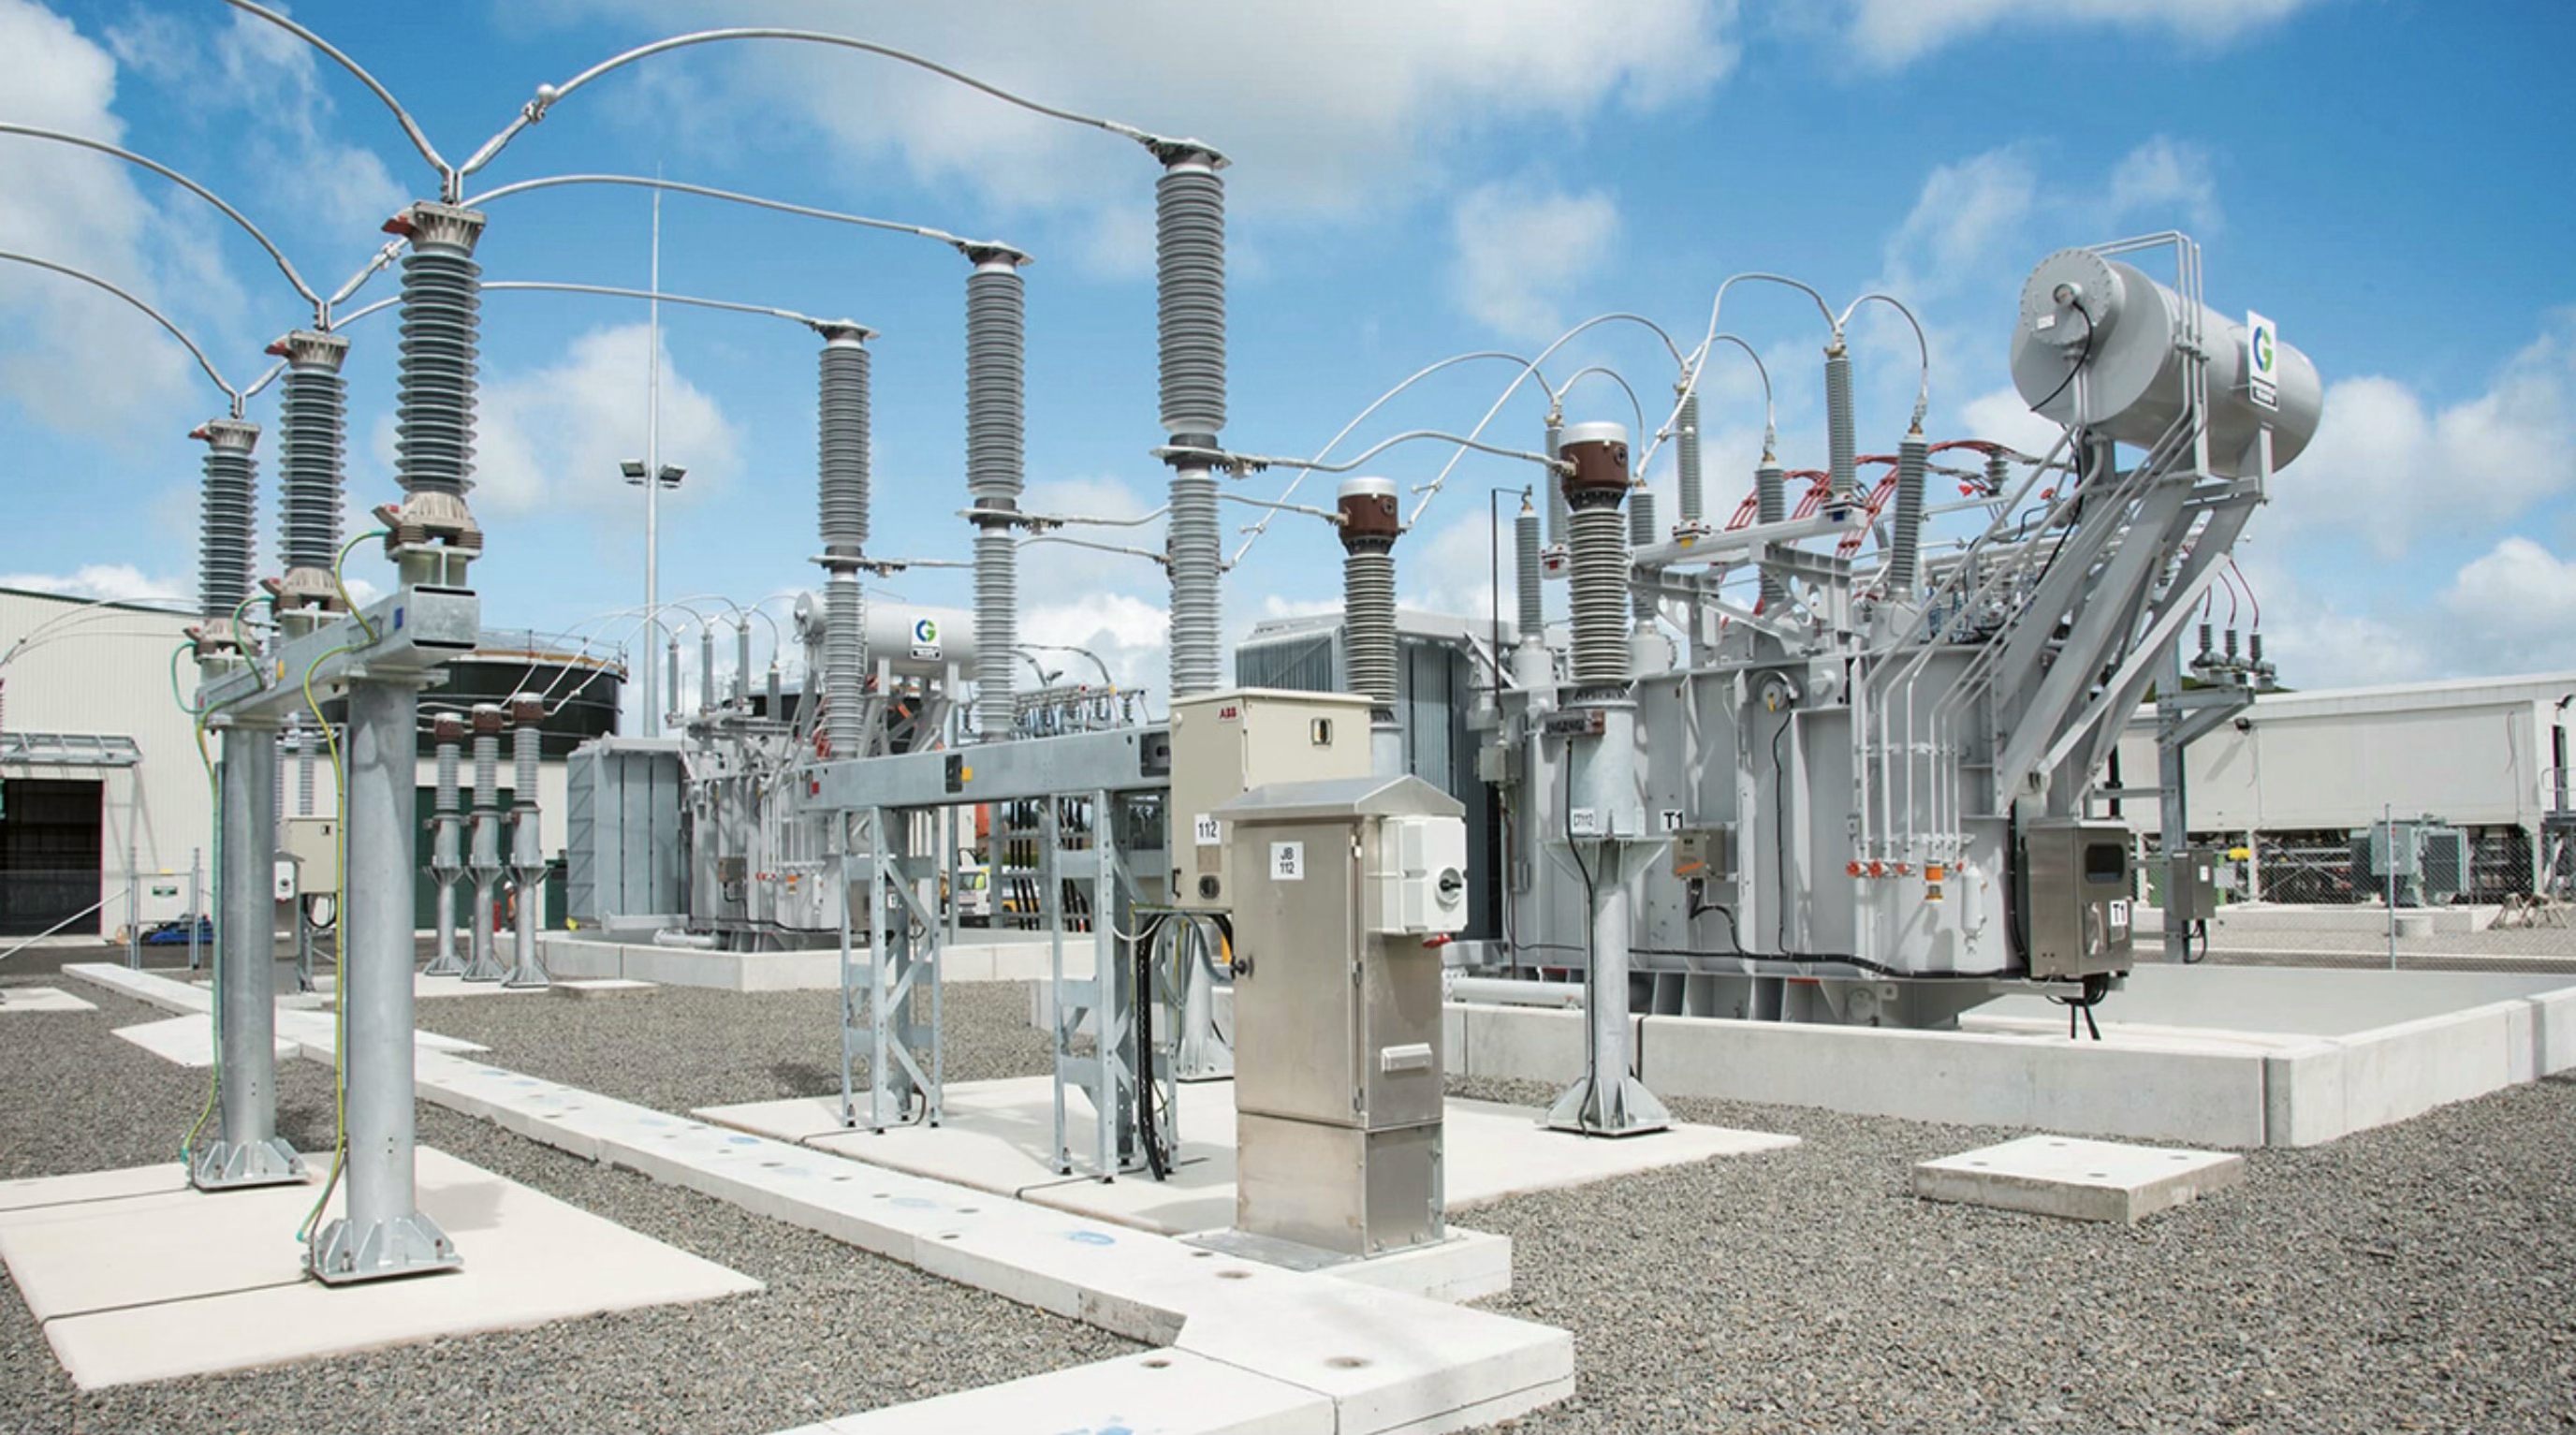 (图片说明)当AI 算力从兆瓦级跃升至吉瓦级,资料中心的用电需求不再只是企业内部的工程问题,而开始等同于一座城市的公共负载。
⸻
算力引擎全速运转,燃料问题成为文明提问
在一般媒体的人物报导里,黄仁勋往往是成功学符号:革新、远见、产品、股价、市值。但黄仁勋在GFM 的叙事中,既不是能源专家,也不是政策官员,而是把算力推到足以逼出三条成本的人:他推动的不是单一产品,而是一个把社会能源底盘推向极限的产业机器;他释放的不是单一预言,而是一个迫使公私部门重新协调、重新投资、重新制定规范的压力场。这也解释了为什么这篇文章不是「反科技」:恰恰相反,它是最成熟的科技观——承认边界、面对成本、才能把技术推向可持续的霸权。
当AI 叙事从狂热的突破期进入2026 的深化期,核心问题正在位移:不再只是「能不能做出来」,而是「能不能持续做下去」。黄仁勋仍会继续推进更强的架构、更密集的机柜、更高的互连吞吐,市场也会继续为更快的token 产能欢呼;但越往下走,越决定胜负的将不是晶片谁更快,而是谁能在现实世界里获得更可靠的供电、更可控的冷却、更可治理的电网接入,以及更少被制度时间拖延的部署节奏。北维吉尼亚的事件提醒我们:AI 工厂不只在增加用电,它还在改写电网运行与可靠性标准;IEA 的预测提醒我们:资料中心用电的国家级规模化是一条大概率路径;而各种市场讯号也在提醒我们:冷却、供电与并网已被单独定价、单独比较、单独成为瓶颈。这些都指向同一个结论:AI 正从「技术浪漫」走向「系统工程」,而系统工程的天花板必然是能源底盘。 GFM 之所以要把黄仁勋放进这三篇组合(程迈越是边界与制度时间的守望者,Sam Altman 是需求曲线的加速器),正因为黄仁勋是供给端最关键的引擎:他让全世界清楚看到,当算力成为文明级基础设施时,燃料问题就不再是背景,而是决定航向的现实。于是最后留给这个时代的提问也变得简单而严峻:算力已到位,我们是否准备好为它供电?
收听本文
加载中…